+ 作る
図を読み込んでいます…
1 / 17

SQL が届いてから結果が返るまで:PostgreSQL の中で起きていること

発行
かえで
版
第3版
改訂
分量
17コマ・5,842字

1行の SELECT が PostgreSQL の中をどう進むのか。パーサ・プランナ・エグゼキュータ、8KB ページと ctid、B-tree が1億行から一瞬で探せる理由、共有バッファ、そして UPDATE・MVCC・WAL から見た ACID まで、順を追って解説します。

はじめに:1行の SQL が旅をする

アプリが SELECT * FROM users WHERE id = 10000; という1行を送ると、データベースの中では何が起きているのでしょうか。ふだん私たちは結果だけを受け取りますが、その裏では「文字列を読み解く」「探し方を決める」「ディスクのどこを読むか決める」「見つけた行を返す」という手順が、きっちり順番に進んでいます。

このアニメモでは PostgreSQL を題材に、その道のりを順に追います。前半は読む側(SELECT)の流れと、1億行あっても一瞬で目的の行にたどり着ける理由。後半は書く側(UPDATE)の流れと、途中で電源が落ちてもデータが壊れない理由(ACID)です。

図は左がアプリ、中央が PostgreSQL、右がデータを置くディスク。SQL はこの左から右へ、結果は右から左へ流れます。
  • SELECT * FROM users WHERE id = 10000;
  • PostgreSQL
  • ノートPC
  • ?
  • ディスク
  • アプリ
  • ディスク
  • アプリ → PostgreSQL → ディスク。SQL は左から右へ、結果は右から左へ流れる

受付:接続ごとに「担当者」が付く

PostgreSQL を起動すると、まず postmaster という親プロセスが待ち受けます。アプリが接続してくると、postmaster は自分の分身(バックエンドプロセス)を1つ fork して、その接続専属の担当者にします。以後、その接続から届く SQL はすべてこの担当者が処理します。接続が 100 本あれば担当者も 100 人いる、という構造です。

SQL は届いた時点ではただの文字列です。担当者はこれを4つの工程に順番に通していきます。パーサ(読み解く)、リライタ(書き換える)、プランナ(探し方を決める)、エグゼキュータ(実際に探す)。この4工程が、どんな SQL でも必ず通る共通の道です。

  • SELECT * FROM users WHERE id = 10000;
  • postmaster(親プロセス)
  • fork
  • PostgreSQL バックエンドプロセス(この接続の担当者)
  • ノートPC
  • パーサ
  • リライタ
  • プランナ
  • エグゼキュータ
  • ディスク
  • アプリ
  • ディスク
  • postmaster が接続ごとにバックエンドを fork。SQL は4つの工程を順に通る

工程1 パーサ:文字列を木に組み立てる

最初の工程はパーサです。やることはプログラミング言語のコンパイラと同じで、文字列を単語(トークン)に切り、文法に照らして木構造に組み立てます。SELECT * FROM users WHERE id = 10000 なら、「SELECT 文」という根の下に、「何を取り出すか(*)」「どこから(users)」「どんな条件で(id = 10000)」という枝がぶら下がった形になります。これをパースツリーと呼びます。

ここで見ているのは文法だけです。users というテーブルが本当にあるのか、id が数値なのかはまだ知りません。SELCT のようなつづり間違いや括弧の閉じ忘れは、この段階で構文エラーとして突き返されます。

  • SELECT * FROM users WHERE id = 10000;
  • PostgreSQL バックエンドプロセス
  • ノートPC
  • パーサ
  • リライタ
  • プランナ
  • エグゼキュータ
  • ディスク
  • SelectStmt
  • アプリ
  • ディスク
  • targetList: *
  • fromClause: users
  • whereClause: id = 10000
  • パーサ:文字列 → パースツリー。見るのは文法だけ。名前の実在や型はまだ知らない

工程2 アナライザとリライタ:名前の正体を確かめる

次に、木に出てくる名前の正体をシステムカタログで調べます。カタログとは PostgreSQL が自分自身の構造を記録しているテーブル群で、「users という名前のテーブルは内部番号 16384」「その id 列の型は integer」といった情報が入っています。定数の 10000 も integer として扱うと決まり、木は意味の確定した「クエリツリー」に変わります。存在しない列名を書くとエラーになるのはこの段階です。

続くリライタは、ルールに従って木を書き換えます。いちばん身近なのはビューです。ビューに対する SELECT は、ここで元のテーブルへの問い合わせに展開されます。行レベルセキュリティの条件が WHERE に足されるのもここです。

  • SELECT * FROM users WHERE id = 10000;
  • PostgreSQL バックエンドプロセス
  • ノートPC
  • パーサ
  • リライタ
  • プランナ
  • エグゼキュータ
  • ディスク
  • アプリ
  • 本
  • users → テーブル(内部番号 16384)が存在する: OK
  • id → 型は integer。定数 10000 も integer として扱う
  • ディスク
  • システムカタログ
  • ビュー・行レベルセキュリティのルールで木を書き換える
  • カタログで名前と型を確定 → クエリツリー。ビューはここで元のテーブルに展開される

工程3 プランナ:どう探すかを決める

ここが RDBMS のいちばん賢い部分です。SQL には「id が 10000 の行がほしい」としか書いてありません。どうやって探すかは書いていないので、プランナが決めます。

候補はたとえば2つ。案Aは Seq Scan、テーブルを頭から全部読んで条件に合う行を拾う方法。案Bは Index Scan、id 列に作られた B-tree 索引で直接たどる方法。プランナは「テーブルは約1億行」「id は重複なし」といった統計情報(ANALYZE で集めたもの)を元に、それぞれが読むページ数と CPU の手間を数値(コスト)で見積もり、いちばん安い案を選びます。この例では案Bが圧倒的に安い。

SQL の前に EXPLAIN を付けると、プランナが選んだ計画とコストをそのまま見ることができます。遅い SQL を調べるときの出発点です。

  • SELECT * FROM users WHERE id = 10000;
  • PostgreSQL バックエンドプロセス
  • 統計: 約1億行・id は一意
  • ノートPC
  • パーサ
  • リライタ
  • プランナ
  • エグゼキュータ
  • ディスク
  • 採用!
  • アプリ
  • 案A Seq Scan on users 全ページを読む cost ≈ 1,700,000
  • 案B Index Scan using users_pkey B-tree で直接たどる cost ≈ 8.6
  • ディスク
  • EXPLAIN を付けると、この見積もりと選ばれた案がそのまま見える
  • 統計情報から各案のコストを見積もり、いちばん安い案を選ぶ。SQL は「どう探すか」を書かない

工程4 エグゼキュータ:計画どおりに動く

選ばれた計画は、実行ノードの木として渡されます。今回は「users_pkey という索引を使って id = 10000 を探し、見つかった行を取り出す」という1つのノードだけ。エグゼキュータはこの木を上から順に「次の1行をくれ」と呼び出していき、ノードは要求されるたびに1行ずつ返します。JOIN や ORDER BY があれば、ノードが積み重なって、下から上へ行が流れていく形になります。

ここから先は「実際にディスクのどこを読むか」の話です。その前に、テーブルのデータがディスク上でどんな形をしているかを見ておきます。

  • SELECT * FROM users WHERE id = 10000;
  • PostgreSQL バックエンドプロセス
  • ノートPC
  • パーサ
  • リライタ
  • プランナ
  • エグゼキュータ
  • ディスク
  • アプリ
  • Index Scan using users_pkey on users Index Cond: (id = 10000)
  • ディスク
  • 「次の1行をくれ」→ 1行返す → 「次は?」→ もう無い → 終了
  • 計画の木を上から「次の1行をくれ」と呼び、ノードが1行ずつ返す。ここからディスクの話へ

データの置き場所:8KB のページが並んだファイル

テーブルの中身は、ディスク上では1つのファイルとして置かれています(ヒープファイル)。ファイルは先頭から 8KB ずつの「ページ」に区切られ、各ページの中に行(タプル)が詰め込まれています。1行が 60 バイト程度なら、1ページに 100 行ちょっと。1億行なら約 83 万ページ、6.7GB ほどになります。

大事なのは、「10000 行目」という番号はどこにも存在しないことです。行の住所は ctid と呼ばれ、「何ページ目の何番目か」の組で表されます(図の (0,1) など)。行はテーブルに入れた順に空いているページへ置かれ、更新や削除で場所も変わります。だから id = 10000 の行がどのページにあるかは、読んでみるか、別に「住所録」を持っていないと分かりません。

  • users テーブルの実体:8KB の「ページ」が並んだ1つのファイル(ヒープ)
  • ページ 0 約120行
  • ページ 1 約120行
  • ページ 2 約120行
  • ページ 3 約120行
  • ページ 4 約120行
  • ページ 5 約120行
  • ページ 6 約120行
  • ページ 7 約120行
  • …
  • ページヘッダ(LSN・空き領域の位置 …)
  • 行の住所 = ctid (ページ番号, 位置) 「10000行目」という 番号は無い
  • (0,1) id=1 name='Aoi' created_at=…
  • (0,2) id=2 name='Ren' created_at=…
  • (0,3) id=3 name='Mio' created_at=…
  • … (0,118) id=118
  • 行の住所は ctid = (ページ番号, ページ内の位置)。「10000行目」という番号はどこにも無い

住所録がないとき:全ページを頭から読む

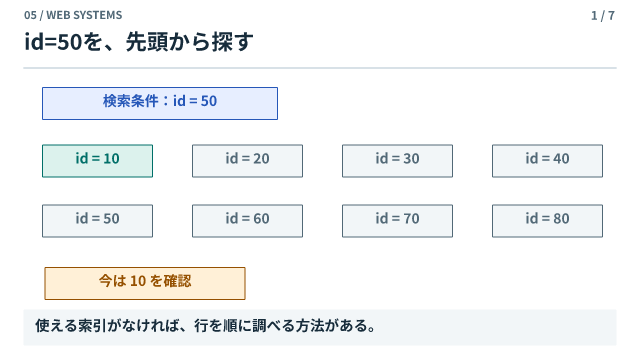
索引(住所録)がなければ、選択肢は Seq Scan しかありません。ページ0から順に 8KB ずつ読み込み、ページの中の行を1つずつ見て、id が 10000 かどうか比べます。見つかっても止まれません。id に重複がないという保証がなければ、最後のページまで読み切る必要があるからです。

1億行なら約 83 万ページ、6.7GB を全部読むことになります。SSD でも数秒から数十秒。これが「索引のない検索は遅い」の正体です。読む量がテーブルの大きさに比例するので、テーブルが 10 倍になれば時間も 10 倍かかります。

  • 索引がないとき:Seq Scan(全走査)
  • ページ 0 読む
  • ページ 1 読む
  • ページ 2 読む
  • ページ 3 読む
  • ページ 4 読む
  • ページ 5 読む
  • ページ 6 読む
  • ページ 7 読む
  • …
  • 検索
  • ページ 0 → 1 → 2 → … → 833,333 まで、全部読んで id を比べる
  • 1億行 ÷ 約120行/ページ ≈ 83万ページ ≈ 6.7 GB 読む量はテーブルの大きさに比例する
  • 読むページ数: 833,333(全部)
  • 索引がなければ約83万ページ(6.7GB)を頭から読む。読む量はテーブルの大きさに比例

住所録の形:B-tree

そこで PostgreSQL は、id 列に対して B-tree という索引を作ります(主キーを付けると自動で作られます)。これは「キーの値 → その行の ctid」という対応表を、木の形に整理したものです。

木の節(ノード)も、やはり 8KB のページです。いちばん上のルートには「7000 まではこっちの子、14000 まではこっちの子」という境目の値が並び、その下の内部ノードがさらに細かく区切り、いちばん下の葉(リーフ)にキーの値と ctid が昇順に並んでいます。1ページには数百個のキーが入るので、1段下がるごとに候補がおよそ数百分の1に絞られます。葉どうしは横にもつながっていて、「id が 10000 以上 20000 以下」のような範囲も、葉を横にたどるだけで取れます。

  • B-tree 索引(users_pkey):「キー → ctid」の対応表を木の形にしたもの
  • … │ 7000 │ 14000 │ 21000 │ …
  • ルート(1ページ)
  • 内部 ノード
  • 1 │ 2500 │ 5000
  • 7000 │ 9000 │ 11000 │ 13000
  • 14000 │ 16500 │ 19000
  • 葉 (リーフ)
  • … │ 8900
  • 9000 │ 9001 …
  • 10000 │ 10001 │ 10002 │ …
  • 11000 │ …
  • 13000 │ …
  • ヒープ(テーブル本体のページ) ← 葉の各キーの隣に、その行の ctid が書いてある
  • ノードはどれも 8KB ページ。1ページに数百のキー → 1段下がるごとに候補が数百分の1に

たどる:ルートから葉へ、3〜4回の分岐

id = 10000 を探すときの動きはこうです。まずルートのページを読み、「10000 は 7000 以上 14000 未満」と比べて真ん中の子へ進みます。その内部ノードを読み、「9000 以上 11000 未満」の葉へ進みます。葉のページを読むと、キー 10000 の隣に ctid = (83, 7) が書いてあります。「83 ページ目の 7 番目の行」という住所です。

ここまでに読んだページは3枚。あとはヒープファイルの 83 ページ目を1枚読んで、7 番目の行を取り出せば終わりです。ページの中での比較は二分探索なので、数百個のキーがあっても 10 回足らずで決まります。

  • id = 10000 を探す:ルート → 内部ノード → 葉 → ヒープ
  • 探す値: id = 10000 7000 ≤ 10000 < 14000 → 真ん中へ
  • … │ 7000 │ 14000 │ 21000 │ …
  • ① ルートを読む(1ページ目)
  • 1 │ 2500 │ 5000
  • 7000 │ 9000 │ 11000 │ 13000
  • 14000 │ 16500 │ 19000
  • ② 9000 ≤ 10000 < 11000 → その葉へ(2ページ目)
  • … │ 8900
  • 9000 │ 9001 …
  • 10000→(83,7) │ 10001→(83,9)
  • 11000 │ …
  • 13000 │ …
  • ③ 葉で 10000 の隣に ctid=(83,7)(3ページ目)
  • ④ (83,7)
  • ヒープ:83 ページ目を読み、7 番目の行を取る
  • ページ 83
  • ルート → 内部 → 葉 の3ページで ctid=(83,7) が分かる。あとはヒープを1ページ読むだけ

なぜ1億行でも一瞬なのか

速さの理由は「読むページの数」にあります。全走査は約 83 万ページを読みました。B-tree なら、1段で数百分の1に絞られるので、1億行でも木の高さは3〜4段。読むページは 4〜5 枚です。しかも上のほうの段は全部の検索で通るので、メモリにキャッシュされていて、実際にディスクまで行くのは葉と、ヒープの1ページくらいです。

テーブルが 100 倍の 100 億行になっても、木は1段増えるだけ。読むページが 1 枚増えるだけです。これが「対数時間」という言葉の意味で、索引が効く検索は、データが増えてもほとんど遅くなりません。

逆に言えば、WHERE に書いた列に索引がない、あるいは WHERE lower(name) = ... のように索引が使えない形で書いてしまうと、プランナは全走査に戻ります。

  • なぜ速いか:読むページの数がまるで違う
  • \log_{300} 10^{8} \approx 3.2
  • … │ 7000 │ 14000 │ 21000 │ …
  • 上の段はほぼ常にメモリ上
  • 1ページ約300キーなら 1億行でも木の高さは 3〜4 段
  • 1 │ 2500 │ 5000
  • 7000 │ 9000 │ 11000 │ 13000
  • 14000 │ 16500 │ 19000
  • … │ 8900
  • 9000 │ 9001 …
  • 10000→(83,7) │ 10001→(83,9)
  • 11000 │ …
  • 13000 │ …
  • 全走査:833,333 ページ
  • B-tree:4〜5 ページ(葉まで 3〜4 枚 + ヒープ 1 枚)
  • 100倍の100億行になっても、木は1段増えるだけ(読むページは 1 枚増えるだけ)
  • 1億行でも高さ3〜4。データが増えても読むページはほとんど増えない = 対数時間

ページを読む:まずメモリ、なければディスク

エグゼキュータが「83 ページ目をくれ」と頼む相手は、ディスクではなくバッファマネージャです。PostgreSQL は共有バッファと呼ばれるメモリ領域にページのコピーを溜めていて、頼まれたページがそこにあればディスクには触れません。なければディスクから 8KB を読み込んで共有バッファに置き、以後の問い合わせはそれを使います。

よく使われるページ(B-tree の上の段、人気のあるテーブルの一部)はほぼ常にメモリにあります。ディスクの読み出しはメモリの数千倍以上遅いので、「どれだけバッファで済ませられるか」が実際の速さを決めます。EXPLAIN (ANALYZE, BUFFERS) を付けると、ヒットした枚数とディスクから読んだ枚数が見えます。

  • SELECT * FROM users WHERE id = 10000;
  • PostgreSQL バックエンドプロセス
  • ノートPC
  • パーサ
  • リライタ
  • プランナ
  • エグゼキュータ
  • ディスク
  • アプリ
  • 共有バッファ(メモリ上のページキャッシュ)
  • ディスク
  • B-tree ルート
  • B-tree 内部
  • B-tree 葉
  • ヒープ ページ 83
  • 無ければ 8KB 読んで渡す
  • まず共有バッファを見る。無ければディスクから 8KB 読んでバッファに置く。上の段はほぼヒット

返す:1行がアプリへ戻る

ヒープページの 7 番目の行を取り出したら、エグゼキュータはそれを「見えていい行か」確認し(この話は後半で)、列の並びを整えて、接続を通じてアプリに返します。索引から「次の行」を求めても、キー 10000 はもう無いので、ここで終了。アプリには1行が届きます。

ここまでが SELECT の一生です。文字列を木にし、意味を確かめ、探し方を選び、索引で住所を引き、メモリ経由でページを読み、行を返す。どれも一瞬ですが、どこかの手順が重くなる(索引がない、統計が古い、バッファに乗らない)と、SQL は急に遅くなります。

  • → 1行:id=10000, name='Haru', created_at=…
  • PostgreSQL バックエンドプロセス
  • ノートPC
  • パーサ
  • リライタ
  • プランナ
  • エグゼキュータ
  • ディスク
  • アプリ
  • 共有バッファ(メモリ上のページキャッシュ)
  • ディスク
  • B-tree ルート
  • B-tree 内部
  • B-tree 葉
  • ヒープ ページ 83
  • 行が見えていいか確認し、列を整えてアプリへ返す。ここまでが SELECT の一生

書く:行は上書きしない

後半は書く側です。UPDATE users SET name = 'Sora' WHERE id = 10000 が来たとき、探すところまでは SELECT と同じです。違うのはその後で、PostgreSQL は見つけた行を上書きしません。古い行はそのまま残し、新しい内容の行を同じページ(または別のページ)に追加します。

各行には、それを作ったトランザクションの番号(xmin)と、消したトランザクションの番号(xmax)が隠し列として付いています。更新とは「古い行の xmax に自分の番号を書き、新しい行の xmin に自分の番号を書く」ことです。この仕組みを MVCC(多版型同時実行制御)と呼びます。

なぜこんな回りくどいことをするか。同じ瞬間に別の接続がこの行を読んでいるかもしれないからです。古い行を残しておけば、読んでいる側は「自分が始まった時点ではまだ 612 番は終わっていない」と判断して古い行を見続けられ、書く側は誰も待たせずに進めます。読みは書きを待たず、書きは読みを待たない。これが PostgreSQL の同時実行の基本です。不要になった古い行は、あとで VACUUM が回収します。

  • UPDATE users SET name='Sora' WHERE id=10000; -- トランザクション 612
  • ヒープ ページ 83
  • ctid │ id │ name │ xmin(作った番号) │ xmax(消した番号)
  • (83,6) │ 9999 │ 'Yui' │ xmin=301 │ xmax=—
  • (83,7) │ 10000 │ 'Haru' │ xmin=500 │ xmax=612 ← 旧版(612 が消した)
  • (83,8) │ 10001 │ 'Sho' │ xmin=302 │ xmax=—
  • (83,9) │ 10000 │ 'Sora' │ xmin=612 │ xmax=— ← 新版(612 が追加)
  • …
  • 別の接続(トランザクション 600 で開始)から見ると: 612 はまだ終わっていない → 旧版 'Haru' が見える。待たされない
  • 上書きせず新しい版を追加。xmin/xmax で「誰が作り、誰が消したか」を記録する = MVCC

消えない:先にログ、あとで本体

変更したページはまずメモリ(共有バッファ)の上で書き換えられます。この時点ではディスク上の本体ファイルは古いままです。ここで電源が落ちたら変更は消えてしまいそうですが、そうはなりません。PostgreSQL は、ページを書き換えると同時に「何をどう変えたか」を WAL(先行書き込みログ)という別のファイルに追記し、COMMIT のときにその WAL をディスクに確実に書き切って(fsync)から、アプリに「コミットしました」と返すからです。

WAL は末尾に追記するだけなので速く、本体ファイルのあちこちに書きに行くより圧倒的に安く済みます。書き換えたページ本体は、後からチェックポイントという節目でまとめてディスクに書かれます。もし途中でクラッシュしても、再起動時に WAL を先頭から再生すれば、コミット済みの変更はすべて本体に反映し直せます。

  • COMMIT; -- トランザクション 612 を確定する
  • メモリ(共有バッファ)
  • ディスク
  • ヒープ ページ 83(書き換え済み = dirty) (83,7) xmax=612 (83,9) 'Sora' xmin=612
  • データファイル(本体) ページ 83 はまだ古いまま → あとでチェックポイントでまとめて書く
  • ② あとで
  • WAL バッファ 変更の記録 + 「COMMIT 612」
  • ① 追記 + fsync
  • WAL ファイル(末尾に追記するだけ) …│83,7 xmax=612│83,9 +Sora│COMMIT 612
  • COMMIT の返事は ① が終わってから。② の前に電源が落ちても、再起動時に WAL を再生して ② をやり直せる
  • ① WAL に追記して fsync → COMMIT を返す。② 本体ページは後でまとめて書く

ACID:ここまでの仕組みを4文字で言う

RDBMS が守る性質を ACID と呼びます。ここまでの部品に対応づけると、それぞれが何で実現されているかが見えてきます。

原子性(Atomicity)は「全部やるか、何もしないか」。トランザクションの変更は複数ページに散らばっても、WAL に COMMIT の記録が書かれたかどうかの一点で決まります。記録の前に落ちれば、再起動後は未コミットとして全部なかったことになります。

一貫性(Consistency)は「決めたルールを破らない」。主キーの重複禁止、外部キー、CHECK 制約などを、書き込みのたびにその場で検査します。破れば文全体がエラーになり、原子性によって巻き戻ります。

分離性(Isolation)は「同時に動く他人の途中経過が見えない」。MVCC のスナップショットで、各トランザクションは自分が始まった時点で確定していた版だけを見ます。

永続性(Durability)は「コミットしたら消えない」。WAL の fsync が完了してから返事をする、という順序が守っています。

  • ACID:ここまでの部品が、それぞれ何を守っているか
  • A
  • C
  • I
  • D
  • 原子性 Atomicity
  • 一貫性 Consistency
  • 分離性 Isolation
  • 永続性 Durability
  • 全部やるか、何もしないか。 WAL に COMMIT の記録が 書かれたかどうかの 一点で決まる
  • 決めたルールを破らない。 主キー・外部キー・CHECK を 書き込みのたびに検査。 破れば文ごと巻き戻る
  • 他人の途中経過が見えない。 MVCC のスナップショットで 自分が始まった時点の 版だけを見る
  • コミットしたら消えない。 WAL を fsync してから 返事をする順序が守る。 クラッシュ後は WAL を再生
  • 書類
  • 守られている
  • 見る
  • ディスク
  • A: WAL の COMMIT 記録 C: 制約の検査 I: MVCC のスナップショット D: WAL の fsync

SQL の読み方:何がほしいかを書き、どう探すかは任せる

最後に、SQL というものの理解の仕方です。SQL は手順を書く言語ではなく、「どんな行がほしいか」を書く宣言型の言語です。どの順で、どの索引で、どのページを読むかは、プランナが統計情報から毎回決めます。だから同じ SQL でも、データ量や索引の有無で動き方が変わります。

実務で効くのは次の3点です。WHERE や JOIN に使う列には索引があるか。遅いときは EXPLAIN (ANALYZE, BUFFERS) で、プランナがどの案を選び、何ページ読んだかを見る。そして書き込みは「上書きではなく追記」なので、更新の多いテーブルは VACUUM と索引の肥大化を気にかける。

アプリから見れば1行の SQL と1行の結果ですが、その間では、字句解析・カタログ参照・コスト計算・B-tree の探索・バッファ管理・WAL への追記が、毎回この順番で動いています。

  • SQL は「何がほしいか」を書く。「どう探すか」はプランナが毎回決める
  • PostgreSQL バックエンドプロセス
  • ノートPC
  • パーサ 文字列→木
  • リライタ カタログ・ビュー
  • プランナ コスト→EXPLAIN
  • エグゼキュータ B-tree→ヒープ
  • ディスク
  • アプリ
  • 共有バッファ(読みも書きもまずここ)
  • ディスク 本体 + WAL
  • B-tree ルート
  • B-tree 内部
  • B-tree 葉
  • ヒープ ページ 83
  • WHERE の列に索引を・EXPLAIN (ANALYZE, BUFFERS) で確認・更新の多い表は VACUUM を意識

0 件のコメント

読み込み中…

権利侵害・不適切な内容の連絡: [email protected]