フロンティアモデルの工夫:メモリと待ち時間を削る
『GPUとLLM』の最終章です。第3章では、GPUの演算器はとても速いのに、LLMの推論、とくに1トークンずつ生成する decode では、HBM からデータを読む時間と待ち時間のほうが壁になることを見ました。第4章では、それでもモデルを載せるための量子化と並列化を扱いました。
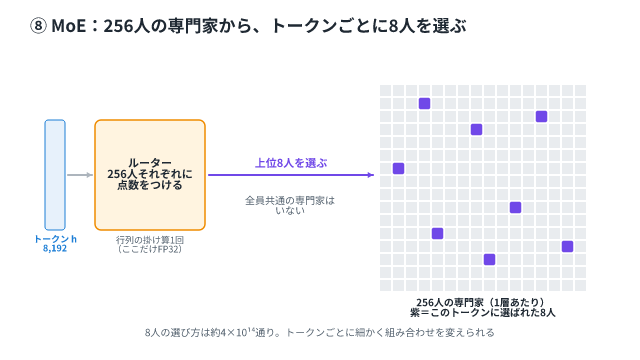
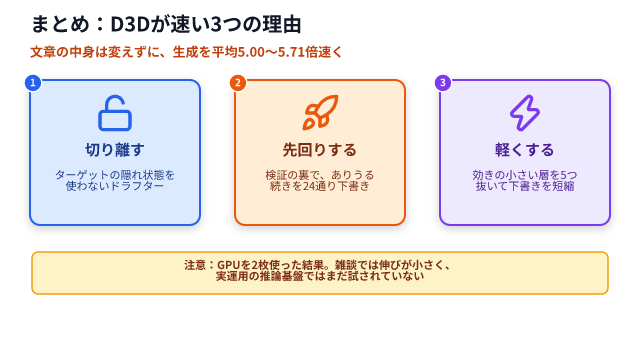
この章では、大規模モデルの設計と運用がその壁をどう削っているかを見ていきます。図の4本のバーが削る対象です。HBMとの往復、KVキャッシュの量、1トークンあたりの計算、そして逐次の待ち。薄い部分が削った量のイメージで、右にそれぞれを削る手法を並べました。以降のページでは、タイトルの下の色付きの札で、いまどれを削っているかを示します。