本
GPUとLLM:グラフィックボードはなぜAIを動かせるのか
かえで全5章・81コマ・25,376字

グラフィックボードの中身から、LLMを動かすのに何が要るのか、なぜGPUが得意なのか、フロンティアモデルがどんな工夫をしているのかまでを、図が動く5章でたどります。たとえ話で済ませずに、行列積の計算量(2mnk)、1トークン≈2N FLOP、KVキャッシュの大きさの式、算術強度とルーフライン、量子化の x≈s×q、all-reduce の通信量、投機的デコーディングの期待値といった、CSとしての数式にも軽く触れます。数値の例には NVIDIA H100 SXM と Llama 3 70B などを使っています。 第1章 GPUの中身:数千のコアとメモリの階層 第2章 LLMは何を計算しているのか:ほとんどが行列積 第3章 なぜGPUが得意なのか:算術強度とルーフライン 第4章 1枚に載らないモデルを動かす:量子化と並列化 第5章 フロンティアモデルの工夫:メモリと待ち時間を削る
章
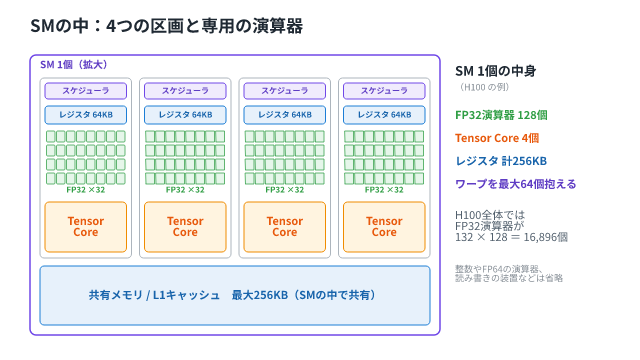
- 第1章 GPUの中身:数千のコアとメモリの階層『GPUとLLM』第1章。画面のピクセルを塗る装置だったGPUが、なぜ大量の計算をさばけるのか。CPUとの設計の違い、SM・ワープ・スレッドの入れ子、Tensor Core、レジスタからHBMまでのメモリの階層を、NVIDIA H100 SXM の数値で見積もりながら、図が動く形で開いていきます。
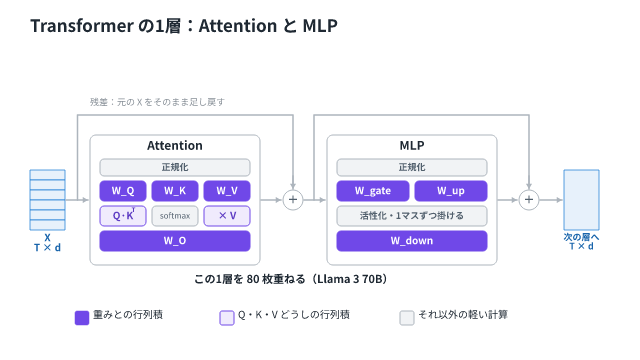
- 第2章 LLMは何を計算しているのか:ほとんどが行列積『GPUとLLM』第2章。文章がトークンと T × d の行列になり、線形層・Attention・MLP のどれもが行列積として計算される様子を、図が動く形でたどります。計算量 2·m·n·k、推論 ≈ 2N・学習 ≈ 6N FLOP、prefill と decode の形の違い、KV キャッシュと重みのメモリまで、Llama 3 70B の寸法を例に概算します。
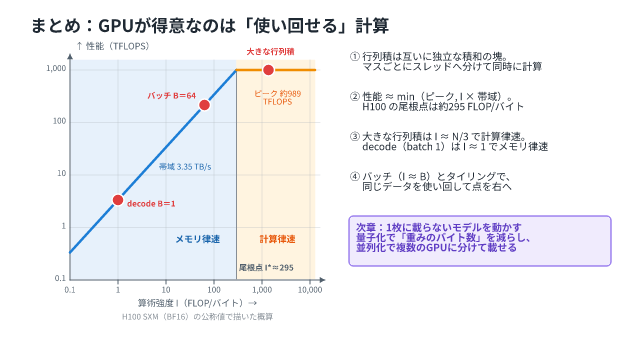
- 第3章 なぜGPUが得意なのか:算術強度とルーフラインGPUはなぜ行列積が得意なのか。算術強度 I=FLOPs÷バイト と、ルーフライン(性能 ≈ min(ピーク, I×帯域))のグラフの上で赤い点を動かしながら、大きな行列積・decode・バッチ・タイリングの違いを見ていきます。『GPUとLLM』第3章。
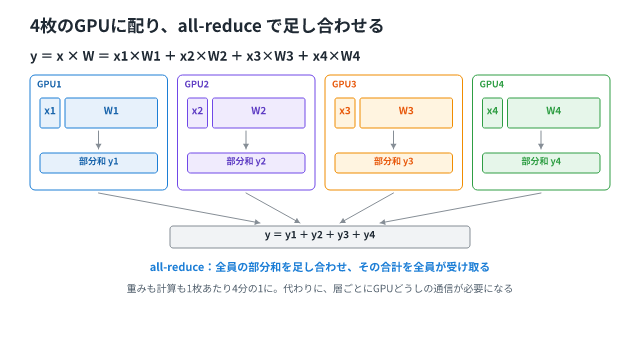
- 第4章 1枚に載らないモデルを動かす:量子化と並列化70Bのモデルは16ビットで約140GB。GPU 1枚(例:80GB)に載らないモデルを、量子化(x ≈ s × q、ブロックごとのスケール)と、テンソル並列・パイプライン並列・データ並列でどう動かすのかを、図が動く形で一段ずつたどります。『GPUとLLM』第4章。
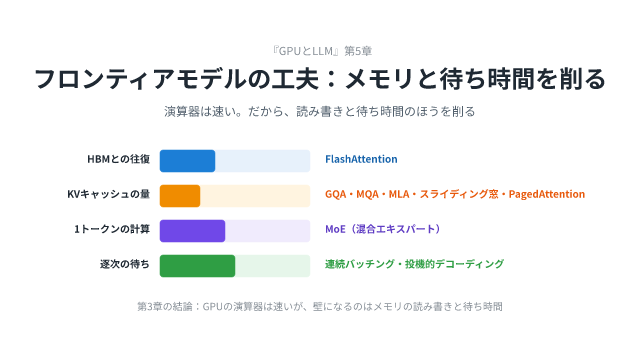
- 第5章 フロンティアモデルの工夫:メモリと待ち時間を削るGPUの演算器は速いのに、LLMはメモリの読み書きと待ち時間で遅くなる。FlashAttention、GQA・MQA・MLA、スライディング窓、PagedAttention、連続バッチング、MoE、投機的デコーディングが、それぞれ「何を減らしているのか」を、図を動かしながら整理します。『GPUとLLM』第5章(最終章)。